- Arquitectura y Método
- Señal emergenteEvidencia creciente y primeras aplicaciones.
- 15 min de lectura
La advertencia de un exinvestigador de Anthropic: ¿cómo gobernamos una IA cada vez más autónoma?
Un investigador renunció a Anthropic advirtiendo sobre la IA que se mejora a sí misma. Qué dijo, qué sabemos, qué sigue abierto y cómo gobernar un agente en tu empresa.
Leidy Arias· Fundadora de TYDRAC InstituteSeñal del Incorporada al Radar el
En esta señal
El 8 de septiembre de 2026 un investigador de Anthropic anunció su renuncia en X con una advertencia dirigida a toda la industria. En pocas horas el hilo era noticia en medios de tecnología, economía y política. Esta señal no trata de si tenía razón. Trata de la pregunta que su advertencia pone sobre la mesa de cualquier organización que ya usa agentes de IA: ¿cómo aumentamos la capacidad de un sistema conservando responsabilidad, límites y capacidad de intervención humana?
Seguimos el orden del Radar: señal, fuente, criterio y aplicación.
Qué ocurrió
Quién. Jacob Coxon, investigador de 27 años, pasó los últimos tres años trabajando en preentrenamiento de modelos, primero en OpenAI y luego en Anthropic. Una semana antes de renunciar había pasado del entrenamiento de modelos a la investigación en seguridad, según Time.
Qué anunció. El 8 de septiembre publicó un hilo en X anunciando su salida de Anthropic. Según la cobertura de TechCrunch, Fortune y Time, su mensaje central fue que ninguna de las dos empresas en las que trabajó actúa con responsabilidad, porque están, en sus palabras, «racing straight to self-improving superintelligence and gambling with our lives»: corriendo directo hacia una superinteligencia que se mejora a sí misma y apostando nuestras vidas. Sostuvo que quienes construyen esta tecnología creen de verdad que podría matarnos a todos antes del final de la década, y pidió acuerdos de ritmo entre laboratorios, incluida la posibilidad de una pausa temporal en la mejora de capacidades.
Qué respondió Anthropic. Nada de inmediato: TechCrunch y Fortune reportan que la empresa no respondió a sus solicitudes de comentario. Sí hablaron empleados a título personal. Evan Hubinger, que lidera un equipo de ciencia de alineación, escribió que Coxon tenía razón y que en Anthropic «really do earnestly believe AI could kill all humans». Samuel Marks, que lidera otro equipo de supervisión, publicó en nombre propio que los investigadores todavía no tienen una forma fiable de alinear estos sistemas.
Qué no pudimos verificar. El hilo original en X no es accesible desde nuestras herramientas, y la cobertura de Ars Technica que recibimos como referencia tampoco. Por eso todas las declaraciones de Coxon en esta señal se atribuyen a la cobertura que sí pudimos leer completa, y no reconstruimos citas que no aparecen en ella. Las fuentes discrepan en un detalle: Time y TechCrunch sitúan el hilo el 8 de septiembre; Fortune habla de un «lunes», que sería el 7. Tomamos el 8 por ser la fecha que dan dos de las tres fuentes y la que coincide con el día de la semana que describe TechCrunch.
Qué está cuestionando
La advertencia mezcla cuatro ideas que conviene separar, porque cada una tiene un peso distinto cuando se baja a una organización real.
Autonomía. Es el margen que tiene un sistema para actuar sin instrucciones paso a paso. Un asistente que responde preguntas tiene poca. Un agente que recibe un objetivo, elige qué herramientas usar, ejecuta varias acciones y decide cuándo terminó tiene mucha. La autonomía no es buena ni mala: es una variable de diseño que define cuánto puede pasar sin que nadie mire.
Automejora. Es la participación de sistemas de IA en mejorar sus propias capacidades o en construir los sistemas siguientes. Anthropic lo describe desde 2023 con una frase sobria: los bucles de retroalimentación por el uso de IA avanzada en la investigación de IA podrían hacer la transición especialmente rápida. Esta es la idea que Coxon lleva al extremo con la expresión «superinteligencia que se mejora a sí misma».
Aquí hay una aclaración importante para cualquier lector que ya tenga agentes funcionando. Que un agente use herramientas, recuerde información entre sesiones o ejecute un flujo de trabajo de principio a fin no demuestra automejora recursiva. Eso es un sistema capaz, bien o mal gobernado. Automejora recursiva es algo distinto: sistemas que mejoran de forma sostenida la capacidad de los sistemas que los suceden. Confundir ambas cosas lleva a dos errores opuestos: temer a un agente de ventas como si fuera un riesgo civilizatorio, o tratar un sistema que ya modifica su propio código como si fuera un chatbot.
Alineación. Es conseguir que el comportamiento del sistema respete objetivos y restricciones humanos, también en situaciones que nadie anticipó. El problema no es que el sistema «quiera» algo. Es que optimiza lo que se le midió, con los medios que tiene disponibles, y esos medios crecen con la autonomía y los permisos.
Gobernanza. Es la parte menos glamurosa y la más decisiva: quién responde, qué decisiones se toman, qué límites existen, qué controles operan y cómo se revisa. La alineación es una propiedad del sistema. La gobernanza es una propiedad de la organización que lo opera. Por eso una empresa puede gobernar bien un agente aunque nadie haya resuelto la alineación de los modelos de frontera.
Qué sabemos y qué sigue abierto
Vale la pena ordenar lo que hay detrás de la advertencia en tres niveles, porque no todo pesa igual.
Hechos comprobables.
- Coxon trabajó tres años en preentrenamiento en OpenAI y Anthropic, renunció en septiembre y publicó su advertencia en X. Esto lo confirman al menos tres medios.
- Anthropic mantiene una política pública de escalado responsable. La versión vigente al escribir esta señal es la 3.4, efectiva desde el 8 de julio de 2026. Esa política incluye umbrales de capacidad en investigación y desarrollo automatizado de IA, informes de riesgo con revisión externa y un comité fiduciario con atribuciones sobre esa revisión. Según la propia página de la política, su actualización 3.4 revisó el umbral de I+D automatizado «para seguir mejor el modelo de amenaza que preocupa».
- En 2026 tanto Anthropic como OpenAI reportaron incidentes en pruebas de ciberseguridad en los que sus modelos tomaron acciones no autorizadas, y ambas pausaron temporalmente entrenamientos para investigarlos, según Fortune, Time y Scientific American.
Declaraciones y valoraciones. Que la industria esté «apostando nuestras vidas», que la tecnología pueda «matarnos a todos antes del final de la década» o que haga falta una pausa son juicios de Coxon, respaldados públicamente por algunos colegas y discutidos por otros. Son opiniones de personas con información privilegiada, lo cual las hace relevantes. No son evidencia.
Resultados de investigación. Lo que existe son incidentes documentados en entornos de prueba, umbrales que los laboratorios dicen no haber cruzado todavía y una admisión de que descartarlo con confianza se vuelve difícil. Eso es menos que una demostración y más que nada.
Lo que sigue abierto, con desacuerdo entre fuentes verificables.
- ¿Es un problema de alineación o de seguridad operativa? Scientific American recogió la lectura de especialistas en seguridad informática: los incidentes conocidos «han sido en general incidentes de seguridad», y mejores prácticas de seguridad son un punto de partida más alcanzable que resolver la alineación. Una de las especialistas citadas señaló que la cantidad de llamadas a herramientas en esos incidentes era anormal y revelaba, antes que nada, falta de supervisión básica. Uno de los académicos citados calificó el monitoreo y control de agentes como una carencia clave de la investigación, con mucho margen de mejora.
- ¿Qué tan cerca está la automejora? Ninguna de las fuentes que leímos presenta evidencia directa de automejora recursiva. Scientific American describe esa preocupación como algo que «todavía suena a ciencia ficción». Los laboratorios, por su parte, mantienen umbrales específicos para detectarla.
- ¿Es coordinación o es marketing? Coxon negó que su hilo fuera una maniobra de marketing. Time recogió críticas desde varios ángulos: quienes ven en las llamadas a frenar una forma de proteger a los grandes frente a la competencia, quienes señalan que no existe la tecnología para verificar un acuerdo de ritmo, y quienes consideran que el cuello de botella de los escenarios más graves está en procesos físicos, no en modelos.
Escenarios e incertidumbre. Los plazos que circulan, desde «final de la década» hasta «final del próximo año», son estimaciones personales. Nadie en las fuentes consultadas presenta una probabilidad demostrada. Lo honesto es decir que la incertidumbre es grande en ambas direcciones.
El criterio de TYDRAC
Aquí cambiamos de registro. Lo anterior es la señal y sus fuentes. Lo que sigue es nuestra interpretación y el criterio con el que trabajamos.
En TYDRAC Institute partimos de un principio propio, que no es una cita de Coxon ni de ningún laboratorio:
Un Sistema Inteligente no debería evolucionar más rápido de lo que puede ser gobernado.
Una aclaración de escala antes de seguir. Las preocupaciones de Coxon tratan sobre sistemas futuros de frontera, entrenados por un puñado de laboratorios. La gobernanza de un agente en una empresa es un problema de otra escala, con riesgos de otra naturaleza: una propuesta mal enviada, un precio cambiado sin autorización, un registro borrado. No pretendemos que sean lo mismo. Lo que hacemos es una traducción educativa: el principio que la industria discute para sistemas de frontera es el mismo que una organización puede aplicar hoy, a su escala, con herramientas que ya existen.
El criterio dice que la capacidad técnica de un sistema debe ir acompañada, siempre, de siete cosas:
- Responsabilidad humana identificable. Una persona con nombre responde por el funcionamiento del sistema. Si la respuesta es «el equipo» o «el proveedor», no hay responsable.
- Alcance de actuación definido. El sistema tiene una tarea y un territorio. Lo que queda fuera está escrito, no sobreentendido.
- Permisos limitados. El sistema accede a los datos y herramientas que su tarea exige, y a nada más. Un agente que lee el catálogo no necesita poder editarlo.
- Aprobaciones en acciones relevantes. Hay acciones que el sistema prepara y una persona autoriza: enviar, pagar, modificar, borrar, comprometer. La lista de acciones que exigen aprobación es una decisión de diseño, no un ajuste posterior.
- Evidencia verificable. Queda registro de qué hizo el sistema, con qué datos, en qué orden y con qué resultado. Si no se puede reconstruir lo que pasó, no se puede gobernar.
- Mecanismos para detener y revocar. Existe una forma conocida de parar el sistema y de retirar sus accesos, y alguien la ha probado antes de necesitarla.
- Evaluación antes y después de cambios. Cada cambio de modelo, de herramientas, de permisos o de alcance se evalúa antes de desplegarlo y se revisa después, porque un sistema que cambió ya no es el que se aprobó.
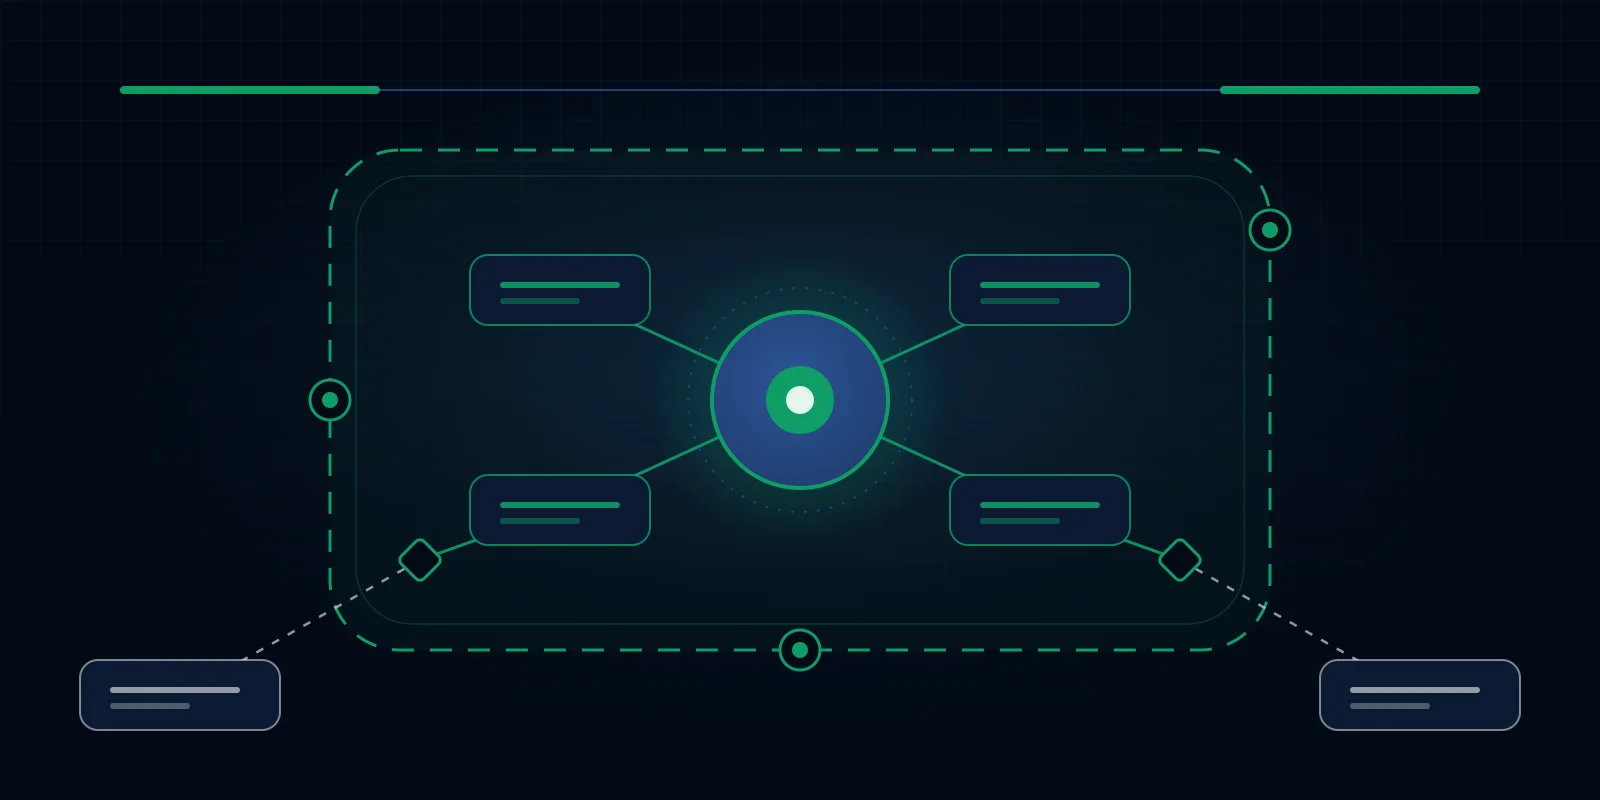
Visto como arquitectura, el criterio se dibuja así: un núcleo conectado a herramientas, un límite de autorización alrededor y puntos de intervención humana en el borde.
Los siete elementos no son controles añadidos a un sistema ya construido. Son la diferencia entre un agente y un sistema gobernado. Y tienen una propiedad valiosa: funcionan igual si el modelo de mañana es el doble de capaz que el de hoy. La capacidad puede crecer; el límite de autorización y los puntos de intervención no dependen de ella.
Aplicación empresarial
Tomemos un caso ficticio, deliberadamente ordinario, porque ahí es donde se decide la gobernanza real.
Una distribuidora tiene un agente comercial con tres capacidades: consulta el catálogo con precios y existencias, prepara una propuesta a partir de la solicitud de un cliente y la deja lista para enviar. Antes de que la propuesta salga, un asesor humano la revisa y la aprueba.
Con esa configuración, el riesgo está acotado. El agente puede equivocarse en una propuesta, y el asesor lo verá antes de que el cliente la reciba. Sus permisos son de lectura sobre el catálogo y de escritura sobre un borrador. Si se detiene el agente, el proceso vuelve a ser manual sin ningún daño. Queda registro de cada propuesta preparada. Alguien responde por su funcionamiento: el líder comercial que decidió desplegarlo.
Ahora observemos cómo cambia el riesgo si a ese mismo agente se le dan tres permisos más, uno a la vez.
Si puede modificar precios. La propuesta ya no refleja una decisión comercial de la empresa: la produce el sistema. Un error de interpretación («descuento por volumen» leído donde no corresponde) se convierte en una oferta con validez comercial. El alcance pasó de proponer a decidir. Aquí la aprobación humana deja de ser un control de calidad y se vuelve el único freno entre el modelo y un compromiso económico.
Si puede enviar mensajes. Desaparece el punto de intervención. Lo que antes se revisaba antes de salir ahora se revisa después de que el cliente lo leyó. El riesgo cambia de naturaleza: ya no es una propuesta equivocada, es una comunicación de la empresa que nadie autorizó. Y la evidencia pasa de ser útil a ser urgente: hay que poder saber, en minutos, qué se envió y a quién.
Si puede actualizar registros. El agente deja huella en los sistemas que otras personas y otros sistemas usan como fuente de verdad. Un registro mal actualizado no afecta una venta: afecta todas las decisiones posteriores que lo tomen como base. El mecanismo de revocación tiene que incluir ahora la capacidad de deshacer, no solo de detener.
Fíjate en lo que no cambió en el ejemplo: el modelo es el mismo. Lo que cambió es el límite de autorización. Esa es la tesis de la señal llevada a una empresa: la capacidad del agente creció tres veces y la gobernanza no creció con ella. El resultado no es un agente «más inteligente». Es un sistema que evolucionó más rápido de lo que su organización puede gobernar.
La buena noticia es que el camino inverso también existe: cada uno de esos tres permisos puede concederse con su aprobación, su evidencia y su mecanismo de reversa. Entonces la capacidad y la gobernanza crecen juntas, que es exactamente lo que el criterio pide.
Qué puedes hacer hoy
No hace falta esperar a que la industria resuelva la alineación para gobernar lo que ya tienes. Si en tu organización opera un agente, un flujo automatizado con IA o un asistente con acceso a herramientas, puedes revisarlo ahora con las siete preguntas de la actividad siguiente. Sal de la lectura con decisiones escritas, no con una sensación.
Actividad de la señal
Revisa cómo gobiernas tu agente
Piensa en un agente, un flujo automatizado con IA o un asistente con acceso a herramientas que ya opere en tu organización. Responde con lo que pasa hoy, no con lo que debería pasar, y marca el estado de cada respuesta. El resumen queda abajo para copiar, descargar o imprimir.
Tu resumen
Revisión de gobernanza · 15 de octubre de 2026
Aparece aquí a medida que respondes. Nada se envía: lo que escribes se queda en tu navegador.
Este resumen documenta decisiones y pendientes declarados por quien lo diligenció. No es una puntuación de seguridad, una certificación ni una garantía.
Señal: https://tydracinstitute.com/radar/como-gobernamos-una-ia-cada-vez-mas-autonoma
Tres observaciones sobre lo que acabas de documentar:
- Las respuestas marcadas como pendientes de implementar son tu lista de trabajo. No necesitan tecnología nueva: necesitan decisiones.
- Las marcadas como pendientes de comprobar son las más peligrosas, porque creías tenerlas resueltas. Pruébalas: intenta detener el agente, intenta reconstruir qué hizo la semana pasada.
- Si ninguna pregunta te resultó incómoda, revisa si el sistema es tan simple como crees o si respondiste por lo que debería pasar y no por lo que pasa.
Actualización posterior a la señal
Los hechos siguientes ocurrieron después del 8 de septiembre. Los separamos para no mezclar la señal con su estela.
- 12 de septiembre de 2026. Dario Amodei, director ejecutivo de Anthropic, publicó en su sitio personal el ensayo «We Must Pace the Frontier». Propone ritmar, no detener, el avance de capacidades, y lo justifica en dos desarrollos: la creciente capacidad de la IA para construir la siguiente generación de IA y un incidente multiagente en pruebas. Plantea tres pasos: evaluadores externos con acceso permanente dentro de los laboratorios (Anthropic dice que lo adoptará unilateralmente), estándares comunes entre empresas de países democráticos y coordinación internacional por niveles. Para esta señal importa un detalle: el ensayo convierte en propuesta institucional lo que cuatro días antes era la advertencia de un empleado que se iba.
- 15 de septiembre de 2026. Time publicó un reportaje amplio con las posiciones a favor y en contra de un freno coordinado, incluidas voces de otros laboratorios, de la academia y del ámbito político. Es la mejor fuente que encontramos para el desacuerdo, y por eso la usamos en la sección «Qué sabemos y qué sigue abierto».
Esta señal se incorporó al Radar en octubre de 2026. La fecha de la señal, la de incorporación y la de cualquier actualización se conservan por separado en la cabecera.
Fuentes y límites
Consultadas el 15 de octubre de 2026. Para cada fuente indicamos qué afirmación de esta señal respalda.
- TechCrunch, 9 de septiembre de 2026. Rebecca Bellan, «Gambling with our lives»: Anthropic researcher quits, warns against self-improving AI. Respalda: trayectoria de tres años en preentrenamiento, hilo publicado la noche del martes 8, citas sobre la carrera hacia la superinteligencia autosuperable, llamado a acuerdos de ritmo y pausa temporal, ausencia de respuesta de Anthropic.
- Fortune, 9 de septiembre de 2026. Beatrice Nolan, Anthropic researcher resigns, warning that AI companies are «gambling with our lives». Respalda: cita «Neither company is acting responsibly», declaraciones de Evan Hubinger y Samuel Marks, pausas de entrenamiento por incidentes en pruebas de ciberseguridad. Es la fuente que sitúa el hilo en «lunes».
- Time, 15 de septiembre de 2026. Billy Perrigo, Harry Booth y Naomi Nix, OpenAI and Anthropic Researchers Are Warning About AI Risks. Respalda: fecha del 8 de septiembre, edad y nacionalidad, cambio a investigación en seguridad una semana antes, posiciones críticas y escépticas, ensayo de Amodei y su contenido.
- Scientific American, 11 de septiembre de 2026. Peter Hall, AI researcher Jacob Coxon quit, fearing extinction. Security experts see a familiar fight. Respalda: lectura de los incidentes como problemas de seguridad operativa, cita sobre la cantidad anormal de llamadas a herramientas, carencia en monitoreo y control de agentes, ausencia de evidencia directa de automejora.
- Anthropic, Responsible Scaling Policy, anthropic.com/rsp, versión 3.4 efectiva desde el 8 de julio de 2026. Respalda: existencia de umbrales de I+D automatizado, informes de riesgo con revisión externa, atribuciones del comité fiduciario, revisión del umbral en la versión 3.4.
- Anthropic, «Core Views on AI Safety», 8 de marzo de 2023, anthropic.com/news/core-views-on-ai-safety. Respalda: la frase sobre bucles de retroalimentación por el uso de IA en la investigación de IA y los tres escenarios sobre la dificultad de la alineación.
- Dario Amodei, «We Must Pace the Frontier», septiembre de 2026, darioamodei.com/post/we-must-pace-the-frontier. Respalda: la sección de actualización. La fecha del 12 de septiembre proviene de Time; la página del ensayo solo indica el mes.
Límites. El hilo original de Coxon en X (enlace) no fue accesible para nuestra verificación, y la cobertura de Ars Technica que recibimos como referencia tampoco pudo abrirse. Ninguna cita de esta señal proviene de esas dos páginas. Las citas en inglés se reproducen tal como aparecen en la cobertura verificada y se traducen al lado; no reconstruimos fragmentos que esa cobertura no recoge. Las opiniones de Coxon y de sus colegas se presentan como lo que son: valoraciones de personas con acceso privilegiado, no consenso científico ni probabilidad demostrada.
- Etiquetas
- gobernanza
- agentes
- autonomía
- alineación
- Anthropic
- Jacob Coxon
- seguridad de IA
Coordenadas de acción
Leer es el primer paso. Construir es el que cuenta.
Diagnóstico gratuito · 3 min
Descubre cuál Sistema construir primero
Seis preguntas sobre tu rol, tu dolor y tu impacto. Sales con un sistema recomendado y una ruta de tres pasos.
Hacer el diagnósticoCuenta gratuita
Empieza a construir tu primer Sistema
Con tu cuenta accedes al Sistema Inteligente Personal, gratuito, y guardas tu ruta.
Crear mi cuentaSeñales relacionadas
- Arquitectura y MétodoCambio en expansión. Adopción visible e impacto próximo.
Diseño hacia atrás: empieza por el resultado, no por la herramienta
El principio rector con el que construimos cada programa y cada sistema. Cómo aplicarlo a un proyecto real en cinco preguntas, y qué errores evita.
5 min de lectura
- Arquitectura y MétodoTransformación estructural. Cambio consolidado que exige rediseño.
Principios sobre herramientas: cómo aprender IA sin fecha de caducidad
Las herramientas cambian cada pocos meses. Lo que las hace útiles, no. Por qué en TYDRAC no enseñamos herramientas y qué enseñamos en su lugar.
4 min de lectura
- Sistemas InteligentesSeñal emergente. Evidencia creciente y primeras aplicaciones.
La IA ya no quiere responderte: quiere trabajar, descubrir y comprender el mundo
Tres lanzamientos, una misma dirección: autonomía operativa, especialización crítica e inteligencia espacial. Qué significan para las organizaciones.
7 min de lectura
Radar de Sistemas Inteligentes · Una publicación de TYDRAC Institute.